KI Workflows
Für IT-Verantwortliche
KI Workflows von Kimiko® bieten Euch die volle technische Tiefe: Ein visueller Workflow-Editor, Python-Skripting, flexible Ablaufsteuerung, direkte Systemanbindung und modulare Architektur.
Hier erfahrt ihr im Detail, wie ihr Workflows konfiguriert, steuert und in Eure IT-Landschaft integriert.
Visuell gestalten, technisch konfigurieren
Der Workflow-Editor ist das zentrale Werkzeug für die Erstellung von KI Workflows. Anstatt Abläufe in Code oder Konfigurationsdateien zu beschreiben, gestaltet ihr den gesamten Workflow grafisch – per Drag & Drop. Jeder Workflow besteht aus einzelnen Tasks, die als Elemente im Editor dargestellt werden. Diese Tasks verbindet ihr über Exit Points zu einem Ablauf mit beliebigen Verzweigungen und Rücksprüngen.
Jeder Task besitzt genau einen Eingangsknoten und kann beliebig viele Exit Points haben – von linearen Abläufen über Mehrfachverzweigungen bis hin zu rekursiven Schleifen. Die Verbindungen zwischen Tasks werden per Drag & Drop erstellt und können jederzeit angepasst werden.
Dabei bleibt die volle Kontrolle erhalten: Hinter jedem visuellen Element stehen konfigurierbare Parameter, Skripte und KI-Instruktionen, die ihr im Plugin-Editor detailliert einstellen könnt.
Drag & Drop für den Überblick. Volle Konfigurationstiefe im Detail.

Der Editor im Überblick:
Tasks als Bausteine
Jeder Workflow besteht aus einzelnen Tasks – visuell dargestellt, frei positionierbar und über Exit Points miteinander verbunden.
Verzweigungen
Über mehrere Exit Points pro Task werden Entscheidungspfade abgebildet – je nach Bedingung wird ein anderer Folge-Task ausgeführt.
Rekursive Abläufe
Tasks können auf frühere Tasks zurückverweisen – ideal für Eingabevalidierungen, Dialogschleifen oder iterative Verarbeitung.
Plugin-Editor
Hinter der visuellen Oberfläche liegt der Plugin-Editor mit allen Detaileinstellungen: Prompts, Skripte, Variablen, KI-Modelle und mehr.
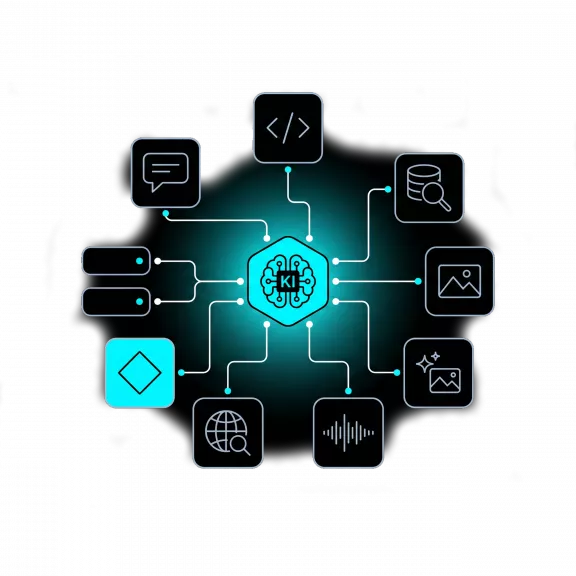
Zwei Task-Typen. Neun Analysemodi. Maximale Flexibilität.
Jeder Task hat einen Typ, der bestimmt, ob eine Benutzerinteraktion stattfindet oder der Schritt im Hintergrund ausgeführt wird. Tasks vom Typ USER stellen dem Benutzer eine Frage und warten auf seine Antwort. Tasks vom Typ AUTO arbeiten eigenständig – sie analysieren, verarbeiten und entscheiden, ohne dass jemand eingreifen muss.
Der Analysemodus legt fest, wie die KI den Task bearbeitet: als reine Textantwort, durch Erstellen und Ausführen eines Python-Skripts, durch Durchsuchen von Informationsquellen, durch Bildanalyse oder -erstellung, durch Sprachverarbeitung, durch Websuche – oder ihr lasst Kimiko® selbst entscheiden, welcher Modus am besten passt.
Das Ergebnis jedes Tasks wird in einer Variablen gespeichert, die in allen Folge-Tasks, Skripten und Prompts über Platzhalter verfügbar ist. Für strukturierte Rückgaben stehen Functions zur Verfügung, die das Ausgabeformat der KI exakt als JSON-Struktur vorgeben – typsicher und ohne zusätzliche Fehlerbehandlung.
Präzise gesteuert. Flexibel kombiniert. Typsicher verarbeitet.
Task-Konfiguration im Überblick:
USER-Tasks
Der Benutzer wird aktiv einbezogen – die KI stellt eine Frage, gibt eine Anweisung oder präsentiert ein Ergebnis und wartet auf die Antwort.
AUTO-Tasks
Verarbeitung im Hintergrund: Daten analysieren, Systeme abfragen, Entscheidungen treffen und Ergebnisse an Folge-Tasks weitergeben – ohne Benutzerinteraktion.
9 Analysemodi
text, script, search, vision, imagine, voice, whisper, browse oder auto – ihr bestimmt für jeden Task, wie die KI arbeitet.
Ergebnis-Variablen
Das Ergebnis jedes Tasks wird in einer benannten Variable gespeichert und ist über Platzhalter (?variable?) in allen Folge-Tasks verfügbar.
Functions
Strukturierte JSON-Rückgaben erzwingen: Feldnamen, Datentypen und Beschreibungen vorgeben – die KI liefert garantiert das erwartete Format.
Python-Skripte für Logik, Steuerung und Systemzugriffe
Hinter jedem Task können zwei Arten von Python-Skripten hinterlegt werden: Das Condition Script steuert den Ablauf – es entscheidet, ob ein Task ausgeführt wird, welcher Exit Point gewählt wird und ob statische Rückgaben ausgegeben werden. Es wird vor und nach der Task-Ausführung aufgerufen. Das Task-Skript ist das zentrale Hauptskript, das die eigentliche Verarbeitung durchführt: Datenbankabfragen, API-Aufrufe, Dateioperationen, Berechnungen und alles, was Python ermöglicht.
Beide Skripttypen haben Zugriff auf die Ergebnisse aller vorherigen Tasks über Platzhalter, auf Parameter, die sensible Daten wie API-Keys oder Datenbankzugangsdaten enthalten, sowie auf Konfigurationsparameter der gesamten Kimiko®-Umgebung. Variablen lassen sich über global_vars für nachfolgende Tasks exportieren.
Skripte werden standardmäßig direkt im Anwendungskontext ausgeführt. Für Skripte, die zusätzliche Python-Bibliotheken benötigen, steht eine Sandbox-Umgebung zur Verfügung, die benötigte Pakete automatisch erkennt und installiert.
Condition Script für den Ablauf. Task-Skript für die Verarbeitung. Python für alles.
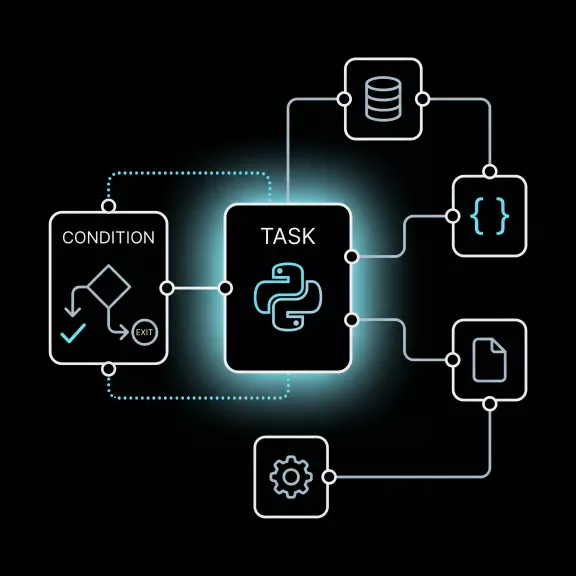
Skripting im Überblick:
Condition Script
Steuert den Workflow: execute_task, use_exit, static_result, static_files, meta_info, document_name und global_vars – alle Steuerungsvariablen auf einen Blick.
Task-Skript
Das Hauptskript des Tasks: Beliebig komplex, mit vollem Python-Funktionsumfang – von Datenbankabfragen über API-Aufrufe bis zur PDF-Erstellung.
Sandbox-Umgebung
Für Skripte mit externen Bibliotheken: Die Sandbox erkennt benötigte Pakete automatisch, installiert sie und führt das Skript isoliert aus.
Sichere Parameter
API-Keys, Datenbankzugangsdaten und andere sensible Werte werden als Parameter hinterlegt – sie werden nicht an die KI oder an Benutzer exponiert.
Datei-Handling
Hochgeladene Dateien lesen aus ../resources/, Ergebnisse speichern in ../results/ – klare Verzeichnisstruktur für Ein- und Ausgabe.

Komplexe Prozesse modular aufbauen
Nicht jeder Workflow muss alles in einem Ablauf abbilden. Mit der Agent-Delegation könnt ihr aus einem Workflow heraus einen anderen Agenten aufrufen – als spezialisierten Sub-Agent für eine Teilaufgabe. Nach Abschluss kehrt die Steuerung zum aufrufenden Workflow zurück, inklusive aller Ergebnisse.
So entstehen modulare Architekturen: Ein Haupt-Agent steuert den Gesamtprozess und delegiert Teilaufgaben an spezialisierte Agents – zum Beispiel einen Agent für die Adresserfassung, einen für die Kundendatenprüfung und einen für die Bestellabwicklung. Jeder dieser Agents kann unabhängig getestet, gewartet und von mehreren Haupt-Agents wiederverwendet werden.
Sub-Agents können im Frontend ausgeblendet werden, sodass sie nur über die Delegation erreichbar sind. Verschachtelte Delegationen über mehrere Ebenen sind ebenso möglich wie die dynamische Auswahl des aufzurufenden Agents über die Ablaufsteuerung.
Modular denken. Einmal bauen. Überall einsetzen.
Delegation im Überblick:
Sub-Agents aufrufen
Aus jedem Task heraus kann ein anderer Agent aufgerufen werden – mit optionaler Angabe des Start-Tasks im Ziel-Agent.
Datenfluss
Variablen fließen in beide Richtungen: Vom Haupt-Agent zum Sub-Agent und zurück – alle Ergebnisse stehen nach der Rückkehr zur Verfügung.
Wiederverwendung
Ein Sub-Agent für die Adresserfassung kann von Bestellprozess, Kundenneuanlage und Schadensmeldung gleichermaßen genutzt werden.
Verschachtelung
Sub-Agents können ihrerseits weitere Agents aufrufen – für mehrstufige Hierarchien. Zirkuläre Referenzen werden automatisch verhindert.
Zeitgesteuert, stapelweise, mit dem richtigen Modell
Nicht jeder Workflow wird durch eine Benutzeraktion ausgelöst. Über den Scheduler könnt ihr Agents in regelmäßigen Intervallen automatisch ausführen – täglich, wöchentlich oder in beliebigen Zyklen. Für die Verarbeitung mehrerer Anfragen in einem Durchlauf steht die Stapelverarbeitung zur Verfügung: Ihr definiert eine Liste von Prompts, legt Datum und Uhrzeit fest, und Kimiko® arbeitet alles nacheinander ab. Die Ergebnisse werden gesammelt und per E-Mail versendet oder in einem Ausgabeordner abgelegt.
Für jeden Agent und jeden einzelnen Task könnt ihr festlegen, welches KI-Modell zum Einsatz kommt – vom Sprachmodell über Bildgenerierung und Sprachausgabe bis hin zu Reasoning-Modellen. Die Modellauswahl folgt einer Hierarchie: Zentrale Einstellung → Agent-Ebene → Task-Ebene. So nutzt ihr für einfache Tasks kostengünstige Modelle und für komplexe Analysen leistungsstarke Spezialmodelle.
Automatisch, planbar und mit dem optimalen Modell für jede Aufgabe.

Automatisierung & Modelle im Überblick:
Scheduler
Agents in konfigurierbaren Intervallen automatisch ausführen – ohne Benutzerinteraktion, zeitgesteuert im Hintergrund.
Stapelverarbeitung
Mehrere Prompts in einem Batch abarbeiten, Ergebnisse aggregieren und per E-Mail versenden – ideal für Reports, Massenanalysen oder Übersetzungen.
Modell-Hierarchie
KI-Modelle lassen sich zentral, pro Agent und pro Task festlegen – von AUTO (Standardmodell) bis zur gezielten Auswahl für jeden einzelnen Schritt.
Modelltypen
LLM, Reasoning, Embedding, Bildgenerierung, Bilderkennung, Sprachausgabe, Spracherkennung, Videogenerierung, Live und Tool – jeder Typ separat konfigurierbar.
Kostenoptimierung
Einfache Tasks mit günstigen Modellen, komplexe Analysen mit leistungsstarken – die granulare Modellwahl ermöglicht gezielte Kostensteuerung.

Euer Netzwerk ist die Schnittstelle
Da Kimiko® on-premises läuft, hat jeder Workflow direkten Zugriff auf alles, was in Eurem Netzwerk erreichbar ist. Es gibt keinen Umweg über externe Cloud-Dienste – der Workflow greift direkt auf Eure Datenbanken, APIs, Dateisysteme und Webanwendungen zu.
Für die Anbindung von Wissensquellen steht ein umfangreicher Scraping-Mechanismus zur Verfügung, der Webseiten, Dokumentenverzeichnisse, Wikis, OneDrive, SharePoint, Audiodateien, Bilddateien und relationale Datenbanken unterstützt. Jede Quelle wird automatisch indexiert und über eine semantische Suche (RAG) durchsuchbar gemacht – mit konfigurierbaren Suchverfahren und Qualitätsprüfung.
Für die direkte Kommunikation mit externen Systemen stehen externe APIs zur Verfügung, die im Admin-Bereich konfiguriert und mit Zugriffssteuerung versehen werden können. Und über die REST-API von Kimiko® selbst können externe Systeme Workflows programmatisch auslösen und Ergebnisse abrufen.
On-Premises heißt: Direkter Zugriff auf alles in Eurem Netzwerk.
Integration im Überblick:
Informationsquellen
HTML, Dokumente, XWiki, OneDrive, SharePoint, Datenbanken, Audiodateien, Bilddateien und externe Module – alle Typen werden unterstützt und automatisch indexiert.
RAG-Suche
Drei Suchverfahren: RAGFILTERED (gefiltert), RAGRAW (ungefiltert) und RAGFREE (alle Daten) – je nach Anforderung an Präzision und Abdeckung.
SQL-Datenbanken
Relationale Datenbanken werden direkt angebunden. Die KI erstellt auf Basis der Benutzeranfrage eigenständig SQL-Queries – basierend auf der hinterlegten Datenbankstruktur.
Externe APIs
APIs werden im Admin-Bereich konfiguriert und mit Instruktionen versehen. Die KI erkennt automatisch, wann welche API relevant ist, und erstellt passende Aufrufe.
REST-API
Kimiko® selbst bietet eine REST-API, über die Workflows von externen Systemen ausgelöst, gesteuert und abgefragt werden können – abgesichert über API-Key und IP-Whitelist.
Bereit zum Bauen?
Ihr habt einen konkreten Prozess im Kopf und möchtet wissen, wie der Workflow technisch umgesetzt wird? Oder ihr möchtet euch den Workflow-Editor und die Konfigurationsmöglichkeiten live anschauen? Wir zeigen Euch alles in einem technischen Deep Dive – von der ersten Task-Konfiguration bis zur produktiven Integration.